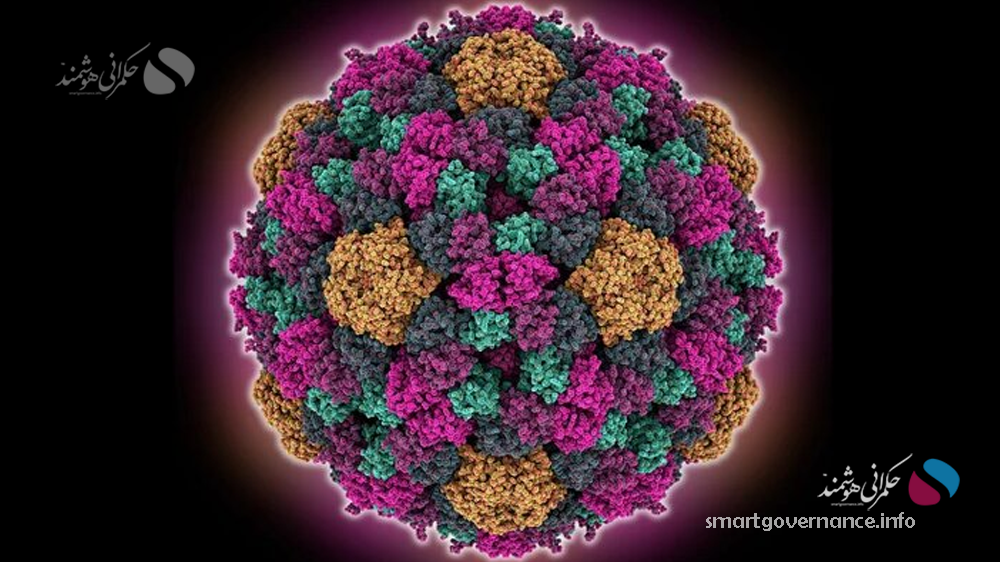
پژوهشگران با ایجاد و بررسی بیش از ۴۴ هزار گونه جهشیافته از ژنوم فاژ ΦX۱۷۴، یکی از گستردهترین آزمایشها برای بررسی اثر تغییرات ژنتیکی را انجام دادهاند؛ آزمایشی که در کنار کشف نکات تازه درباره زیستشناسی این ویروس، محدودیت مدلهای پیشرفته هوش مصنوعی در پیشبینی پیامد جهشها را نیز آشکار کرده است.
به گزارش پایگاه خبری حکمرانی هوشمند، فاژ ΦX۱۷۴ که با نام «فایاکس» نیز شناخته میشود، از جمله ویروسهایی است که سابقه طولانی در مطالعات ژنتیکی دارد. ژنوم این ویروس از ۵۳۸۶ نوکلئوتید تشکیل شده و ۱۱ پروتئین را رمزگذاری میکند. همین سابقه مطالعاتی گسترده باعث شده بود این ویروس گزینه مناسبی برای بررسی دقیق رابطه میان تغییرات ژنتیکی و عملکرد زیستی باشد.
در این مطالعه، پژوهشگران تقریبا تمام تغییرات ممکن در نوکلئوتیدهای منفرد ژنوم را ایجاد کردند. آنها علاوه بر این، تغییرات مختلف در اسیدهای آمینه پروتئینهای ویروس را نیز مورد بررسی قرار دادند و در مجموع بیش از ۴۴ هزار گونه متفاوت از ژنوم فاژ ایجاد کردند.
هدف اصلی این آزمایش، بررسی میزان تأثیر هر یک از این تغییرات بر توانایی ویروس برای بقا و تکثیر بود. برای این منظور، گونههای جهشیافته در کنار باکتری اشرشیا کلی که به عفونت فایاکس حساس است، کشت داده شدند.
نتایج نشان داد بخش قابل توجهی از جهشها برای ویروس زیانبار هستند. حدود نیمی از جهشهای تکنوکلئوتیدی و ۶۰ درصد جهشهایی که موجب تغییر اسیدهای آمینه میشدند، توانایی ویروس را برای ادامه حیات و تکثیر کاهش دادند.
بن لهنر، زیستشناس مولکولی در موسسه ولکام سنگر و از رهبران این پژوهش، با اشاره به میزان ناشناختههای موجود حتی در این ویروس بهخوبی مطالعهشده، گفت: «حتی در این سامانه که به شدت مورد مطالعه قرار گرفته است، نمیتوانیم توضیح دهیم که چرا یک چهارم جهشها باعث مرگ ویروس میشوند.»
بررسی دقیقتر جهشها نشان داد بخشی از تغییرات زیانبار احتمالا بر نحوه تعامل پروتئینهای ویروس با یکدیگر یا با پروتئینهای میزبان اثر گذاشتهاند. گروه دیگری نیز در بخشهای داخلی ساختار پروتئینها رخ داده بودند و احتمالا یکپارچگی ساختاری آنها را مختل میکردند. با این حال، درباره صدها جهش دیگر هنوز توضیح روشنی وجود ندارد.
لِهنر درباره این بخش از نتایج گفت: «صدها جهش در این مجموعه وجود دارد که هیچ ایدهای نداریم چه کاری انجام میدهند.»
آزمایش مدلهای هوش مصنوعی
پژوهشگران در مرحله بعد تلاش کردند از ابزارهای هوش مصنوعی برای تفسیر بهتر نتایج استفاده کنند. برای برخی پروتئینهای فاژ، ساختارهای آزمایشگاهی از قبل مشخص شده بود، اما درباره همه پروتئینها چنین اطلاعاتی وجود نداشت. در این موارد، پژوهشگران از ساختارهای پیشبینیشده توسط مدل AlphaFold ۳ کمک گرفتند.
این ساختارهای پیشبینیشده توانستند در برخی موارد محل تجمع جهشهای زیانبار را مشخص کنند؛ از جمله در ناحیهای از یک پروتئین که در تکثیر DNA ویروسی نقش دارد.
با این حال، زمانی که عملکرد ۲۰ مدل هوش مصنوعی طراحیشده برای پیشبینی اثر جهشها مورد ارزیابی قرار گرفت، نتایج آنطور که انتظار میرفت امیدوارکننده نبود.
حتی مدلهای پیچیدهای که با حجم عظیمی از اطلاعات مربوط به توالیهای زیستی آموزش دیده بودند، در این آزمایش نتوانستند عملکردی بهتر از یک مدل بسیار ساده داشته باشند؛ مدلی که تنها محل وقوع جهش در یک پروتئین را در نظر میگرفت.
لِهنر درباره عملکرد این مدلها اظهار کرد: «مدلهای هوش مصنوعی عملکرد بدی ندارند، اما فوقالعاده هم نیستند. نکته شگفتانگیز این است که تقریبا هیچکدام از آنها بهتر از یک مدل بسیار، بسیار ساده عمل نمیکنند. دلیل این موضوع هنوز مشخص نیست.»
به اعتقاد پژوهشگران، یکی از دلایل احتمالی این ضعف میتواند کمبود دادههای آموزشی باکیفیت درباره ویروسها، بهویژه فاژهایی مانند فایاکس، باشد. این مسئله بار دیگر نشان میدهد که توسعه مدلهای هوش مصنوعی زیستی صرفا به افزایش پیچیدگی الگوریتمها وابسته نیست و دسترسی به دادههای تجربی گسترده نیز اهمیت زیادی دارد.
پل یاشکه، زیستشناس مصنوعی در دانشگاه مککواری، استفاده از ساختارهای پروتئینی پیشبینیشده با هوش مصنوعی را روشی امیدوارکننده برای سرعت بخشیدن به تحلیل دادههای جهشی میداند، اما تأکید دارد که برای اطمینان از دقت این پیشبینیها به شواهد بیشتری نیاز است.
ادوارد مارکوت، زیستشیمیدان تکاملی در دانشگاه تگزاس در آستین، نیز این مطالعه را پژوهشی ارزشمند و نقطه عطفی در بررسی ارتباط میان جهشها و شایستگی زیستی توصیف کرده است. به گفته او، اجرای چنین روشی در موجودات پیچیدهتر نیز قابل تصور است، هرچند با افزایش پیچیدگی موجودات، انجام آزمایش در این مقیاس دشوارتر خواهد شد.
نیاز به دادههای تجربی بیشتر
یکی از مهمترین پیامهای این پژوهش، ضرورت تولید دادههای تجربی بیشتر برای توسعه مدلهای هوش مصنوعی زیستی است. پژوهشگران معتقدند مدلهایی که قرار است اثر تغییرات ژنتیکی را پیشبینی کنند، باید با مجموعه دادههایی آموزش ببینند که ارتباط میان توالی DNA، تغییرات پروتئینی و عملکرد واقعی موجود زنده را بهصورت دقیق نشان میدهند.
لِهنر نتایج این مطالعه را هشداری برای توسعهدهندگان ابزارهای هوش مصنوعی زیستی میداند؛ زیرا به گفته او، ارزیابی عملکرد مدلها باید با معیارهای دقیقتری انجام شود و همزمان حجم بسیار بیشتری از دادههای تجربی تولید شود.
او درباره مسیر پیشرو گفت: «تا زمانی که این دادهها را تولید نکنیم، این مدلها هیچ وقت کار نخواهند کرد.»
گروه پژوهشی در ادامه قصد دارد بررسی را از جهشهای منفرد فراتر ببرد و تأثیر ترکیبی چندین جهش در ژنوم فاژ فایاکس را مطالعه کند. این مرحله میتواند اطلاعات بیشتری درباره نحوه تعامل تغییرات ژنتیکی با یکدیگر و دشواری پیشبینی اثر آنها در سامانههای زیستی فراهم کند.
در مجموع، این مطالعه نشان میدهد حتی در مورد یک ویروس کوچک و بهشدت مطالعهشده نیز هنوز فاصله قابل توجهی میان دانستن توالی ژنتیکی و درک کامل عملکرد زیستی آن وجود دارد؛ فاصلهای که مدلهای هوش مصنوعی نیز در حال حاضر قادر به پر کردن کامل آن نیستند.
انتهای پیام